anonimize.it
anonimize.it anonimiza y seudonimiza datos sensibles en documentos — íntegramente en su propia máquina.
No se sube nada. Los documentos permanecen donde están: en el dispositivo que usted controla.
PC con sistema operativo Microsoft Windows 11
Local por diseño
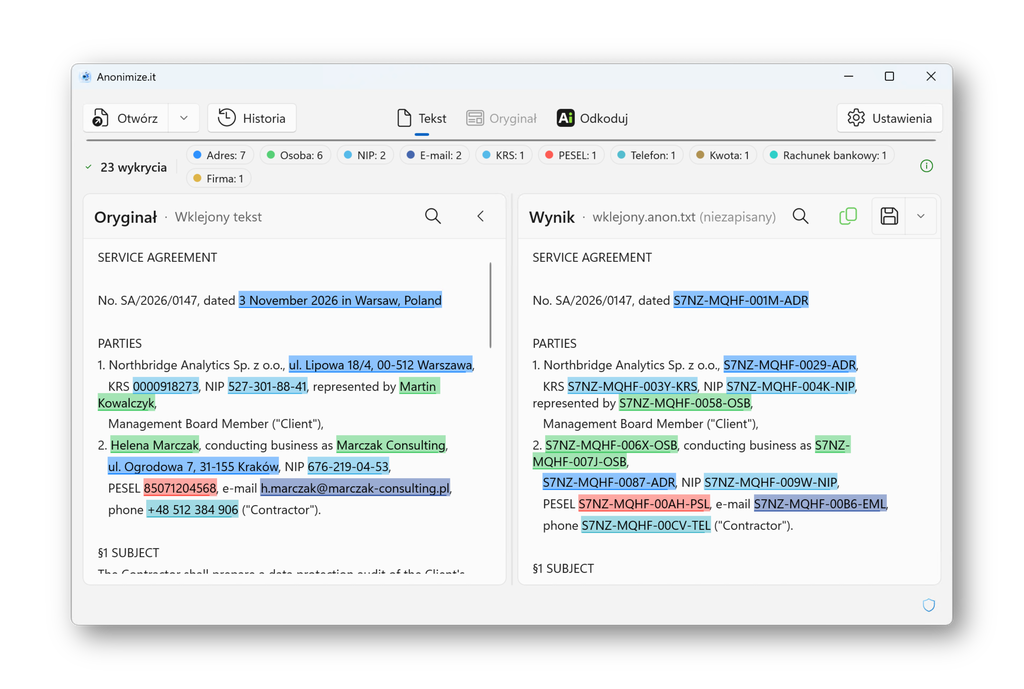
anonimize.it está pensado para situaciones en las que los datos personales no deben salir de su entorno. La anonimización y la seudonimización se ejecutan en la estación de trabajo frente a usted.
- El procesamiento se realiza en su ordenador.
- El contenido de los documentos no se envía a un servicio remoto.
- Un encaje práctico en flujos de trabajo orientados al RGPD que mantienen los datos personales bajo control local.
Escritorio, CLI y OCR
La misma idea en distintas plataformas: trabajar con documentos sin enviarlos a otro lugar.
- Escritorio para Windows y macOS Una aplicación gráfica para el trabajo diario de anonimización.
- CLI para Linux Una herramienta de línea de comandos para scripts, servidores y entornos sin interfaz gráfica.
- OCR para escaneos Compatibilidad con documentos escaneados cuando el texto solo está disponible como imagen.
Formatos admitidos
La salida conserva el mismo formato que la entrada.
Documentos
- .DOCX
- .RTF
- .TXT
Escaneos e imágenes (OCR local)
- PDF del escáner
- .JPG
- .PNG
- .TIFF
- .BMP
- .GIF
En la próxima versión
- .DOC
- .ODT
- .XLSX
- .ODS
- .PPTX
- .WEBP
Novedades
-
- Nuevo tipo de máscara «Eliminar»: el fragmento seleccionado desaparece del resultado sin token de sustitución. En la vista de dos paneles en macOS y Windows — tachado en el origen, vista previa del resultado vacía y deshacer. El contenido eliminado no llega al TXT, a la exportación DOCX/PDF, al mapa ni a la caché (incluidos los escaneos OCR). Disponible en la GUI (macOS/Windows) y en la CLI (detect / process --annotations).
- Lista de producto integrada de unos 12 000 bancos de la UE/EEE/UK/CH/Balcanes (sello aitm/eu-banks, atribución ECB/GLEIF). Los nombres de bancos de esta lista se detectan automáticamente en todas las versiones — sin mantener una lista propia.
-
- Por defecto, el texto de encabezados y pies repetidos ya no se incluye en la salida de texto (exportación TXT, copiar para la IA, vista previa de texto). La detección y el enmascarado siguen aplicándose al texto completo, y la exportación PDF/DOCX conserva el diseño y enmascara cada aparición. Un ajuste en las apps de macOS y Windows (y la opción CLI --include-header-footer-text) recupera el comportamiento anterior con secciones etiquetadas de encabezado/pie al final.
- Reconocimiento de números de teléfono internacionales más allá de Polonia y Croacia: números +CC / 00CC con separadores habituales, validados según las longitudes del plan de numeración de países de la UE/EEE, Reino Unido, Suiza, los Balcanes y Norteamérica (NANP); números nacionales que empiezan por 0 solo tras una etiqueta de teléfono (phone, Telefon, tél., telefono, Handy, mobile, fax…).
-
- Enmascarado de importes monetarios: nuevo tipo de dato «Importe» (etiqueta [KWOTA_n]) para números con un marcador de moneda antes o después de los dígitos (p. ej. 500 zł, 100 €, $500), incluidas las escritas en letra junto a una moneda. Los números, porcentajes y participaciones sin moneda no se enmascaran. Disponible en las listas de reglas de las apps de macOS y Windows; códigos reversibles admitidos.
- Los nombres de empresas conocidos de una lista integrada (bancos que operan en Polonia, empresas WIG20/mWIG40, grandes firmas de TI y seguros), con variantes de nombre, flexión polaca y tickers cortos en mayúsculas, se detectan automáticamente en todas las versiones — sin mantener una lista propia.
-
- El OCR ahora procesa páginas PDF formadas por muchas teselas de imagen (escaneos en «mosaico»): se renderiza la página completa antes del OCR. En macOS la aplicación avisa con claridad cuando el OCR no pudo reconocer texto en una página.
- La salida de texto (TXT, copiar a la IA, vista previa) de PDF de texto y DOCX termina ahora con secciones separadas «Contenido del encabezado» / «Contenido del pie» en lugar de repetir encabezados y pies en cada página del cuerpo. La exportación en el formato original conserva el diseño y enmascara cada aparición en cada página. No aplica a escaneos OCR.
- OIB croata (11 dígitos con suma de control, también con el prefijo de IVA HR) como tipo de dato propio en macOS y Windows con códigos reversibles, y números de teléfono croatas (+385/00385 siempre; números nacionales 0xx cuando están etiquetados como teléfono). La detección funciona independientemente del idioma del documento.
- Windows: en la pestaña «Descodificar» los dos paneles se desplazan sincronizados párrafo a párrafo, y un conector de párrafos (cintas que enlazan cada párrafo con códigos con el mismo párrafo con los datos restaurados) se puede activar en Ajustes. Marcar o desmarcar una frase ahora se aplica a todas sus apariciones con un clic.
-
- Windows: un solo modelo sencillo de anonimización sin modo que elegir — todo lo que es texto (vista Texto, .anon.txt, Copiar, también texto OCR de escaneos e imágenes) siempre recibe códigos reversibles; todo lo que es documento (vista previa del resultado, guardar DOCX / PDF / escaneo / imagen) siempre se oculta (campos negros, irreversible). Los PDF escaneados y las imágenes ya se pueden guardar como documento con datos ocultos. La pestaña “Decodificar” es una herramienta aparte: pega o suelta texto con códigos de muchos documentos, en la página de resumen de desanonimización ves de qué documentos provienen los códigos y cuáles quedaron desconocidos, y desde ahí puedes cargar el documento de origen.
-
- Windows y CLI (Linux): el texto anonimizado usa ahora códigos reversibles en lugar de etiquetas simples; el resultado de cada documento se guarda en un historial local de documentos cifrado (clave en el almacén de credenciales del sistema), así que al reabrir un archivo se recupera el resultado anterior. Página de Historial (Ctrl+H) con carpetas, búsqueda (también por código), ordenación, eliminación y ajustes de retención. Decodificar una respuesta de IA: pega texto, o abre/arrastra un archivo .txt, .md, .docx o .rtf — los códigos de muchos documentos distintos se restauran a los datos originales en un solo paso. La CLI ganó los comandos `registry` y `restore`.
- Reconocimiento de nombres de localidades polacas a partir de registros oficiales de nombres (TERYT, PRNG) y del diccionario de flexión SGJP, incluidas las formas flexionadas; se enmascaran como dirección.
-
- macOS: un nuevo panel flotante de utilidad Ventana → “Información del archivo” muestra el nombre del archivo, el estado del motor y el estado de la sesión; permanece encima y se actualiza en vivo con la ventana activa. Esta información se sacó de la ventana principal para que la vista del documento quede más limpia. Cerrar el panel no detiene el procesamiento. El botón Guardar y Archivo → Guardar… / Cmd+S están desactivados cuando no se ha detectado ni enmascarado nada (sin entidades), así que no se puede exportar por accidente un documento sin cambios; se activan en cuanto aparece una máscara.
- Una sola palabra con mayúscula inicial entre dos partes del mismo nombre de persona en la misma línea (p. ej. un segundo nombre entre el nombre y el apellido) ahora se enmascara como parte de esa persona, aunque no se haya encontrado por separado.
-
- Windows: el original del documento y su vista previa (DOCX, PDF, escaneo, imagen) se ven justo tras la carga, mientras la detección de datos sigue en curso; la búsqueda (Ctrl+F) ya funciona sobre el original. La tarjeta de progreso muestra la fase actual (lectura de texto o documento, OCR del escaneo, detección) con el número de caracteres o páginas, con opción de cancelar.
-
- Windows: nueva pestaña “Respuesta IA” junto a Texto/Original (Ctrl+R). A la izquierda pegas texto con etiquetas (típicamente la respuesta de un asistente de IA) y a la derecha ves de inmediato el mismo texto con los datos originales restaurados del mapa de la sesión actual, resaltados por tipo. La restauración se hace en vivo en memoria — sin escribir en disco archivos con datos personales. Reconoce variantes de etiquetas que suele generar la IA (p. ej. [Osoba 1], [osoba_1], OSOBA_1) y avisa de etiquetas fuera del mapa. Copiar y Guardar (.odtworzony.txt). También se puede cargar un mapa JSON guardado previamente sin un documento abierto.
- Windows: zoom del texto — Ctrl+rueda del ratón cambia el tamaño en la vista Texto y en los paneles “Respuesta IA” (75–225%); también Ajustes → General → “Tamaño del texto” con restablecimiento al 100%. El nivel se recuerda.
-
- Windows: vista previa del resultado anonimizado para PDF escaneados e imágenes directamente en la vista del documento (PDF ráster o imagen); antes solo disponible en la vista Texto.
- La detección en archivos .txt grandes ahora se ejecuta en tiempo lineal — antes archivos de ~1 MB podían tardar más de 10 minutos.
- La exportación PDF con muchas entidades distintas es unas 5× más rápida (p. ej. PDF de prueba de 19 páginas: de unos 30 s a unos 6 s).
-
- La regla de URL también enmascara dominios sin esquema (p. ej. example.pl sin http/www), direcciones IPv4 sueltas y host:port, además de apellidos pegados a un dominio o un correo. Usa una lista conservadora de TLD permitidos para evitar falsos positivos en abreviaturas.
- Asignaciones permanentes definidas por el usuario en archivos .aitm: listas de frases (prioridad: nombres de empresas) que siempre se enmascaran. La coincidencia tolera mayúsculas/minúsculas, formas jurídicas (S.A./SA/sp. z o.o.), espacios y ampersand y una inflexión polaca ligera. Disponible en la CLI (--aitm, --aitm-dir, --no-aitm) y en la app de Windows (elección de la carpeta .aitm, contador de entradas). Aún no en la interfaz de macOS.
- Ficha de auditoría de anonimización (para TI/archivo, responsabilidad del RGPD art. 5(2)) sin originales ni valores sustituidos: solo recuentos por tipo de dato, extensión del archivo y SHA-256; JSON + HTML. Indicador CLI --audit RUTA y `anonimize audit --map …`; en Windows, menú “Guardar ficha de auditoría…”. Aún no en la interfaz de macOS. La ficha también se genera cuando el procesamiento está bloqueado (fail-closed).
- PDF: los archivos adjuntos incrustados (EmbeddedFiles, anotaciones FileAttachment) se eliminan por completo del resultado, con una advertencia.
- Mejor OCR en escaneos de baja resolución: las imágenes incrustadas pequeñas se amplían antes del OCR, de modo que los nombres en esos escaneos se leen con más fiabilidad; sin ralentizar los escaneos A4 normales.
-
- PDF: las páginas de un escaneo se reconocen con OCR en paralelo en varios núcleos (hasta 8 páginas a la vez). Las páginas en blanco del escaneo ya no interrumpen el procesamiento: se omiten y la aplicación avisa qué páginas estaban en blanco.
- PDF: texto correcto desde archivos con codificación de caracteres no estándar (p. ej. MacRoman, tablas /Differences, campos de formulario) y desde flujos de objetos comprimidos, de modo que las letras polacas (ą, ł, ś…) se leen y anonimizan correctamente. División de páginas y exportación más fiables también en PDF con sintaxis inusual.
- Mejor detección de nombres y apellidos ocultos en direcciones de correo y nombres de dominio, también con ruido de OCR, y de nombres escritos en minúsculas.
-
- Nuevo tipo de datos: direcciones URL. Detección y enmascarado de direcciones completas (http/https/ftp/sftp/ssh/file/git/ws/mailto, www. sin esquema, IP con puerto) como [URL_n], con opción de desactivar este tipo. También se limpian los destinos ocultos de hipervínculos en DOCX (campos HYPERLINK, información sobre herramientas, enlaces en imágenes) y en PDF (acciones URI, enlaces a archivos externos).
- macOS: navegador de datos detectados en el panel izquierdo — árbol por páginas (PDF, DOCX) o por tipo; un clic desplaza hasta el lugar del documento. Si el PDF tiene formularios bloqueados, la aplicación no detiene el trabajo: guarda el texto anonimizado (TXT) con el mapa y muestra una advertencia.
- Windows: «No anonimizar» incluye todas las apariciones del mismo valor en el documento, tras confirmación.
- Windows: «Abrir con → Anonimize.it» en el Explorador de archivos para los formatos admitidos (TXT, DOCX, PDF, RTF, imágenes), sin asumir el programa predeterminado.
- Windows: confirmación antes de sustituir el documento abierto por un archivo soltado en la ventana.
- Las cadenas con forma de PESEL, NIP, REGON, KRS, VIN, IBAN/NRB, número de documento de identidad, pasaporte o fecha se enmascaran también cuando la suma de control es incorrecta o la fecha no existe en el calendario (p. ej. un error tipográfico en el PESEL). Si el contexto no resuelve el tipo, el fragmento recibe la etiqueta «ambiguo» en lugar de omitirse.
-
- El guardado del resultado DOCX es unas 10× más rápido — en un documento de prueba largo (~97 mil caracteres, ~1 600 detecciones) de unos 26 s a unos 2,8 s; en la aplicación también acelera la actualización de la vista previa del resultado tras cada edición.
- Windows: edición de la aparición concreta seleccionada en la vista previa DOCX/PDF (no la primera del documento); una selección con el ratón en la vista previa abre de inmediato la edición, y un clic derecho en una detección resaltada permite cambiar su tipo, omitirla o eliminarla.
- Windows: se puede cargar un documento que está abierto en Word (la aplicación lee la última versión guardada).
- PDF: el texto guardado en formularios y campos PDF (incluido el aspecto de anotaciones y campos, p. ej. casillas de verificación) ahora se detecta y anonimiza junto con el contenido de la página.
- Windows: los mensajes de guardado, copia, error y advertencia aparecen en el pie de la ventana, con color según el tipo, y ya no cubren el resultado.
-
- Windows: vista previa del original DOCX y PDF con resaltado de los datos detectados, vista previa de imágenes y desplazamiento sincronizado de ambos paneles (incluida la barra de desplazamiento).
- Windows: seleccione un fragmento en la vista previa del documento y márquelo para anonimizar desde el menú «Marcar».
- Windows: el instalador instala automáticamente el runtime WebView2 si falta.
- Windows: nuevo diseño de ventana — barra con el recuento de detecciones y la leyenda de tipos, búsqueda en los paneles y guardado/copia del resultado desde la barra del panel de resultado.
- macOS: aviso cuando el modelo de reconocimiento de nombres no se ha cargado; guardar, copiar y arrastrar el resultado requieren entonces una confirmación consciente.
- PDF: una imagen que no puede procesarse con seguridad no se incluye en el documento de salida.
-
- Windows: la aplicación abre DOCX, PDF (también escaneos), RTF e imágenes; el OCR (Tesseract) se instala junto con la aplicación.
- Windows: leyenda de tipos de datos, subrayados de color y paso entre detecciones con F3.
-
- Windows: nueva aplicación para Windows con instalador — detección de datos en el texto, edición manual de detecciones, guardado del resultado, página de configuración y panel de avisos.
- Windows: un mapa de seudonimización (JSON) permite restaurar los valores originales en texto etiquetado, p. ej. en una respuesta de un asistente de IA.
- Reconocimiento de nombres propios polacos flexionados (p. ej. «Annie», «Pawła») mediante el diccionario flexivo SGJP.
- El enmascarado con caracteres # ya no revela la longitud de la palabra original.
-
- DOCX: también se anonimizan encabezados, pies de página, notas a pie y metadatos del documento.
- macOS: vista previa rápida del original con marcas de color en DOCX y doble clic para saltar a una detección.
- PDF: sustitución de texto más fiable en archivos con fuentes incrustadas (ToUnicode) y en PDF judiciales.
Para quién es
Abogados, bufetes, tribunales, administración pública y empresas que tratan datos personales y necesitan anonimización cerca del origen.
Por qué anonimize.it
- Trabajar con IA con seguridad Enmascare → trabaje en IA (p. ej. Claude Code, ChatGPT) → restaure los datos. Los valores sensibles del texto se convierten en códigos reversibles; el historial local de documentos permite restaurar los originales después.
- CLI para Linux Enmascara y restaura desde el terminal, para usar en sus propios scripts.
- Totalmente sin conexión Los datos no salen de su ordenador; la aplicación funciona sin internet. Sin telemetría y sin activación en línea.
Precios
Planes para equipos jurídicos. Hable con nosotros sobre la licencia para su organización.
Todos los precios sin IVA.
-
Por puesto
79 PLN por puesto al mes con facturación anual
99 PLN por puesto al mes con facturación mensual
-
Equipo
4.800 PLN al año
-
Piloto gratuito
30–45 días para equipos jurídicos
Contacto
anonimize.it es un spin-off de AdActa. Hable con nosotros sobre licencias, implantación o su caso de uso.