anonimize.it
anonimize.it anonimiza e pseudonimiza dados sensíveis em documentos — inteiramente na sua própria máquina.
Nada é enviado. Os documentos ficam onde estão: no dispositivo que controla.
PC com sistema operativo Microsoft Windows 11
Local por conceção
anonimize.it foi criado para situações em que os dados pessoais não podem sair do seu ambiente. A anonimização e a pseudonimização correm na estação de trabalho à sua frente.
- O processamento decorre no seu computador.
- O conteúdo dos documentos não é enviado para um serviço remoto.
- Um encaixe prático em fluxos de trabalho orientados para o RGPD que mantêm os dados pessoais sob controlo local.
Ambiente de trabalho, CLI e OCR
A mesma ideia em várias plataformas: trabalhar com documentos sem os enviar para outro lado.
- Ambiente de trabalho para Windows e macOS Uma aplicação gráfica para o trabalho diário de anonimização.
- CLI para Linux Uma ferramenta de linha de comandos para scripts, servidores e ambientes sem interface gráfica.
- OCR para digitalizações Suporte para documentos digitalizados quando o texto só está disponível como imagem.
Formatos suportados
A saída mantém o mesmo formato da entrada.
Documentos
- .DOCX
- .RTF
- .TXT
Digitalizações e imagens (OCR local)
- PDF do scanner
- .JPG
- .PNG
- .TIFF
- .BMP
- .GIF
Na próxima versão
- .DOC
- .ODT
- .XLSX
- .ODS
- .PPTX
- .WEBP
Novidades
-
- Novo tipo de máscara «Remover»: o fragmento selecionado desaparece do resultado sem token de substituição. Na vista de dois painéis no macOS e no Windows — rasurado na origem, pré-visualização do resultado vazia e anulação. O conteúdo removido não entra no TXT, na exportação DOCX/PDF, no mapa nem na cache (incluindo digitalizações OCR). Disponível na GUI (macOS/Windows) e na CLI (detect / process --annotations).
- Lista de produto integrada com cerca de 12 000 bancos da UE/EEE/UK/CH/Balcãs (selo aitm/eu-banks, atribuição ECB/GLEIF). Os nomes de bancos desta lista são detetados automaticamente em todas as versões — sem manter uma lista própria.
-
- Por predefinição, o texto de cabeçalhos e rodapés repetidos deixa de ser incluído na saída de texto (exportação TXT, copiar para a IA, pré-visualização de texto). A deteção e o mascaramento continuam a correr sobre o texto completo, e a exportação PDF/DOCX mantém o layout e mascara cada ocorrência. Uma definição nas apps macOS e Windows (e a opção CLI --include-header-footer-text) restaura o comportamento anterior com secções etiquetadas de cabeçalho/rodapé no fim.
- Reconhecimento de números de telefone internacionais para além da Polónia e da Croácia: números +CC / 00CC com separadores comuns, validados face aos comprimentos do plano de numeração para países da UE/EEE, Reino Unido, Suíça, Balcãs e América do Norte (NANP); números nacionais que começam por 0 apenas após uma etiqueta de telefone (phone, Telefon, tél., telefono, Handy, mobile, fax…).
-
- Mascaramento de montantes monetários: novo tipo de dados «Montante» (etiqueta [KWOTA_n]) para números com um marcador de moeda antes ou depois dos dígitos (p. ex. 500 zł, 100 €, $500), incluindo formas por extenso junto de uma moeda. Números, percentagens e participações sem moeda não são mascarados. Disponível nas listas de regras das apps macOS e Windows; códigos reversíveis suportados.
- Os nomes de empresas conhecidos de uma lista integrada (bancos que operam na Polónia, empresas WIG20/mWIG40, grandes firmas de TI e seguros), incluindo variantes de nomes, flexão polaca e tickers curtos em maiúsculas, são detetados automaticamente em todas as versões — sem manter uma lista própria.
-
- O OCR trata agora páginas PDF compostas por muitos mosaicos de imagem (digitalizações em «mosaico»): a página inteira é renderizada antes do OCR. No macOS a aplicação avisa claramente quando o OCR não conseguiu reconhecer texto numa página.
- A saída de texto (TXT, copiar para a IA, pré-visualização) de PDFs de texto e DOCX termina agora com secções separadas «Conteúdo do cabeçalho» / «Conteúdo do rodapé» em vez de repetir cabeçalhos e rodapés em cada página no corpo. A exportação no formato original mantém o layout e mascara cada ocorrência em cada página. Não se aplica a digitalizações OCR.
- OIB croata (11 dígitos com soma de controlo, também com o prefixo de IVA HR) como tipo de dados próprio no macOS e no Windows com códigos reversíveis, e números de telefone croatas (+385/00385 sempre; números nacionais 0xx quando assinalados como telefone). A deteção funciona independentemente do idioma do documento.
- Windows: no separador «Descodificar» os dois painéis deslocam-se em sincronia parágrafo a parágrafo, e um conector de parágrafos (fitas que ligam cada parágrafo com códigos ao mesmo parágrafo com os dados restaurados) pode ser ativado nas Definições. Marcar ou desmarcar uma frase aplica-se agora a todas as suas ocorrências com um clique.
-
- Windows: um único modelo simples de anonimização sem modo a escolher — tudo o que é texto (vista Texto, .anon.txt, Copiar, também texto OCR de digitalizações e imagens) recebe sempre códigos reversíveis; tudo o que é documento (pré-visualização do resultado, gravar DOCX / PDF / digitalização / imagem) tem sempre os dados ocultados (campos pretos, irreversível). PDFs digitalizados e imagens podem agora ser gravados como documento com dados ocultados. O separador “Descodificar” é uma ferramenta à parte: cole ou largue texto com códigos de muitos documentos, na página de resumo da desanonimização vê de que documentos vêm os códigos e quais ficaram desconhecidos, e a partir daí pode carregar o documento de origem.
-
- Windows e CLI (Linux): o texto anonimizado passa a usar códigos reversíveis em vez de etiquetas simples; o resultado de cada documento fica num histórico local de documentos encriptado (chave no armazenamento de credenciais do sistema), pelo que reabrir um ficheiro recupera o resultado anterior. Página de Histórico (Ctrl+H) com pastas, pesquisa (também por código), ordenação, eliminação e definições de retenção. Descodificar uma resposta de IA: cole texto, ou abra/arraste um ficheiro .txt, .md, .docx ou .rtf — códigos de muitos documentos diferentes são restaurados para os dados originais num só passo. A CLI ganhou os comandos `registry` e `restore`.
- Reconhecimento de nomes de localidades polacas com base em registos oficiais de nomes (TERYT, PRNG) e no dicionário de flexão SGJP, incluindo formas flexionadas; mascarados como morada.
-
- macOS: um novo painel flutuante de utilitário Janela → “Informações do ficheiro” mostra o nome do ficheiro, o estado do motor e o estado da sessão; permanece no topo e atualiza-se em tempo real com a janela ativa. Esta informação saiu da janela principal para a vista do documento ficar mais limpa. Fechar o painel não interrompe o processamento. O botão Guardar e Ficheiro → Guardar… / Cmd+S ficam desativados quando nada foi detetado nem mascarado (sem entidades), para não exportar por engano um documento inalterado; ativam-se assim que aparece uma máscara.
- Uma única palavra com maiúscula inicial entre duas partes do mesmo nome de pessoa na mesma linha (p. ex. um nome do meio entre o nome próprio e o apelido) passa a ser mascarada como parte dessa pessoa, mesmo que não tenha sido encontrada separadamente.
-
- Windows: o original do documento e a sua pré-visualização (DOCX, PDF, digitalização, imagem) aparecem logo após o carregamento, ainda durante a deteção de dados; a pesquisa (Ctrl+F) já funciona no original. O cartão de progresso mostra a fase atual (leitura de texto ou documento, OCR da digitalização, deteção) com o número de caracteres ou páginas, com opção de cancelar.
-
- Windows: novo separador “Resposta IA” junto a Texto/Original (Ctrl+R). À esquerda cola texto com etiquetas (tipicamente a resposta de um assistente de IA) e à direita vê de imediato o mesmo texto com os dados originais restaurados do mapa da sessão atual, destacados por tipo. A restauração corre em tempo real na memória — sem gravar no disco ficheiros com dados pessoais. Reconhece variantes de etiquetas que a IA tende a produzir (p. ex. [Osoba 1], [osoba_1], OSOBA_1) e avisa sobre etiquetas fora do mapa. Copiar e Guardar (.odtworzony.txt). Também se pode carregar um mapa JSON guardado anteriormente sem um documento aberto.
- Windows: zoom do texto — Ctrl+roda do rato altera o tamanho na vista Texto e nos painéis “Resposta IA” (75–225%); também Definições → Geral → “Tamanho do texto” com reposição para 100%. O nível é lembrado.
-
- Windows: pré-visualização do resultado anonimizado para PDFs digitalizados e imagens diretamente na vista do documento (PDF raster ou imagem); antes só disponível na vista Texto.
- A deteção em ficheiros .txt grandes corre agora em tempo linear — antes ficheiros de ~1 MB podiam demorar mais de 10 minutos.
- A exportação PDF com muitas entidades diferentes é cerca de 5× mais rápida (p. ex. PDF de teste com 19 páginas: de cerca de 30 s para cerca de 6 s).
-
- A regra de URL também mascara domínios nus (p. ex. example.pl sem http/www), endereços IPv4 nus e host:port, bem como apelidos colados a um domínio ou e-mail. Usa uma lista conservadora de TLD permitidos para evitar falsos positivos em abreviaturas.
- Mapeamentos permanentes definidos pelo utilizador em ficheiros .aitm: listas de frases (prioridade: nomes de empresas) que são sempre mascaradas. A correspondência tolera maiúsculas/minúsculas, formas jurídicas (S.A./SA/sp. z o.o.), espaços e ampersand e uma ligeira flexão polaca. Disponível na CLI (--aitm, --aitm-dir, --no-aitm) e na aplicação Windows (escolha da pasta .aitm, contador de entradas). Ainda não na interface macOS.
- Ficha de auditoria de anonimização (para TI/arquivo, responsabilização do RGPD art. 5.º, n.º 2) sem originais e sem valores substituídos: apenas contagens por tipo de dados, extensão do ficheiro e SHA-256; JSON + HTML. Opção CLI --audit CAMINHO e `anonimize audit --map …`; no Windows, menu “Guardar ficha de auditoria…”. Ainda não na interface macOS. A ficha também é produzida quando o processamento está bloqueado (fail-closed).
- PDF: os anexos incorporados no ficheiro (EmbeddedFiles, anotações FileAttachment) são removidos por completo do resultado, com um aviso.
- Melhor OCR em digitalizações de baixa resolução: imagens incorporadas pequenas são ampliadas antes do OCR, para que os nomes nessas digitalizações sejam lidos com mais fiabilidade; sem abrandamento em digitalizações A4 normais.
-
- PDF: as páginas de um scan são reconhecidas com OCR em paralelo em vários núcleos (até 8 páginas de uma vez). As páginas em branco no scan já não interrompem o processamento — são ignoradas e a aplicação avisa quais páginas estavam em branco.
- PDF: texto correto a partir de ficheiros com codificação de caracteres não standard (p. ex. MacRoman, tabelas /Differences, campos de formulário) e de fluxos de objetos comprimidos, para que as letras polacas (ą, ł, ś…) sejam lidas e anonimizadas corretamente. Divisão de páginas e exportação mais fiáveis também em PDF com sintaxe invulgar.
- Melhor deteção de nomes e apelidos ocultos em endereços de e-mail e nomes de domínio, também com ruído de OCR, e de nomes escritos em minúsculas.
-
- Novo tipo de dados: endereços URL. Deteção e mascaramento de endereços completos (http/https/ftp/sftp/ssh/file/git/ws/mailto, www. sem esquema, IP com porta) como [URL_n], com opção de desativar este tipo. Também se limpam os destinos ocultos de hiperligações em DOCX (campos HYPERLINK, sugestões, ligações em imagens) e em PDF (ações URI, ligações a ficheiros externos).
- macOS: navegador dos dados detetados no painel esquerdo — árvore por páginas (PDF, DOCX) ou por tipo; um clique desloca até ao sítio no documento. Quando o PDF tem formulários bloqueados, a aplicação não interrompe o trabalho: grava o texto anonimizado (TXT) com o mapa e mostra um aviso.
- Windows: «Não anonimizar» inclui todas as ocorrências do mesmo valor no documento, após confirmação.
- Windows: «Abrir com → Anonimize.it» no Explorador de ficheiros para os formatos suportados (TXT, DOCX, PDF, RTF, imagens), sem assumir o programa predefinido.
- Windows: confirmação antes de substituir o documento aberto por um ficheiro largado na janela.
- Cadeias com a forma de PESEL, NIP, REGON, KRS, VIN, IBAN/NRB, número de bilhete de identidade, passaporte ou data são mascaradas mesmo quando a soma de controlo está errada ou a data não existe no calendário (p. ex. um erro tipográfico no PESEL). Quando o contexto não resolve o tipo, o fragmento recebe o rótulo «ambíguo» em vez de ser omitido.
-
- Gravação do resultado DOCX cerca de 10× mais rápida — num documento de teste longo (~97 mil caracteres, ~1 600 deteções) de cerca de 26 s para cerca de 2,8 s; na aplicação acelera também a atualização da pré-visualização do resultado após cada edição.
- Windows: edição da ocorrência concreta selecionada na pré-visualização DOCX/PDF (e não a primeira no documento); uma seleção com o rato na pré-visualização abre de imediato a edição, e um clique direito numa deteção destacada permite alterar o tipo, omiti-la ou removê-la.
- Windows: é possível carregar um documento que está aberto no Word (a aplicação lê a última versão gravada).
- PDF: o texto guardado em formulários e campos PDF (incluindo o aspeto de anotações e campos, p. ex. caixas de verificação) é agora detetado e anonimizado em conjunto com o conteúdo da página.
- Windows: as mensagens de gravação, cópia, erro e aviso aparecem no rodapé da janela, com cor consoante o tipo, e já não cobrem o resultado.
-
- Windows: pré-visualização do original DOCX e PDF com destaque dos dados detetados, pré-visualização de imagens e deslocamento sincronizado de ambos os painéis (incluindo a barra de deslocamento).
- Windows: selecione um excerto na pré-visualização do documento e marque-o para anonimização no menu «Marcar».
- Windows: o instalador instala automaticamente o runtime WebView2 se estiver em falta.
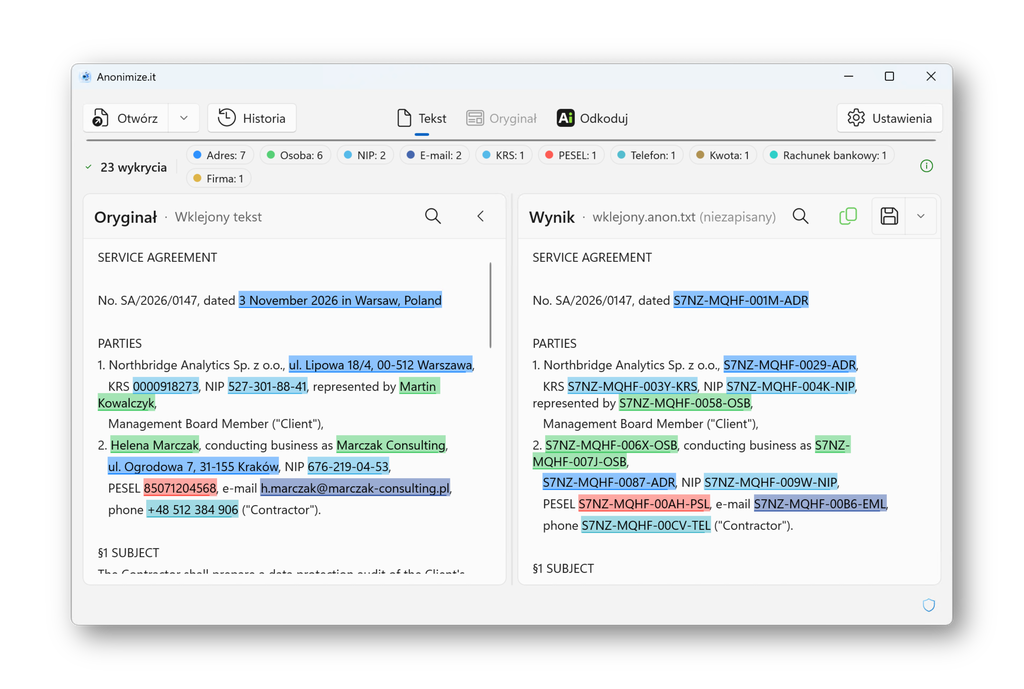
- Windows: nova disposição da janela — barra com a contagem de deteções e a legenda de tipos, pesquisa nos painéis e gravação/cópia do resultado a partir da barra do painel de resultado.
- macOS: aviso quando o modelo de reconhecimento de nomes não foi carregado; gravar, copiar e arrastar o resultado exigem então uma confirmação consciente.
- PDF: uma imagem que não pode ser processada em segurança não entra no documento de saída.
-
- Windows: a aplicação abre DOCX, PDF (incluindo digitalizações), RTF e imagens; o OCR (Tesseract) é instalado juntamente com a aplicação.
- Windows: legenda de tipos de dados, sublinhados coloridos e passagem entre deteções com F3.
-
- Windows: nova aplicação para Windows com instalador — deteção de dados no texto, edição manual de deteções, gravação do resultado, página de definições e painel de avisos.
- Windows: um mapa de pseudonimização (JSON) permite restaurar os valores originais em texto com etiquetas, p. ex. numa resposta de um assistente de IA.
- Reconhecimento de nomes próprios polacos flexionados (p. ex. «Annie», «Pawła») graças ao dicionário flexional SGJP.
- A mascaragem com caracteres # já não revela o comprimento da palavra original.
-
- DOCX: também são anonimizados cabeçalhos, rodapés, notas de rodapé e metadados do documento.
- macOS: pré-visualização rápida do original com marcas coloridas em DOCX e duplo clique para saltar para uma deteção.
- PDF: substituição de texto mais fiável em ficheiros com tipos de letra incorporados (ToUnicode) e em PDF judiciais.
Para quem é
Advogados, escritórios de advocacia, tribunais, administração pública e empresas que tratam dados pessoais e precisam de anonimização perto da origem.
Porquê anonimize.it
- Trabalhar com IA em segurança Mascarar → trabalhar em IA (p. ex. Claude Code, ChatGPT) → restaurar os dados. Os valores sensíveis no texto passam a códigos reversíveis; o histórico local de documentos permite restaurar os originais depois.
- CLI para Linux Mascara e restaura a partir do terminal, para usar nos seus próprios scripts.
- Totalmente offline Os dados não saem do seu computador; a aplicação funciona sem internet. Sem telemetria e sem ativação online.
Preços
Planos para equipas jurídicas. Fale connosco sobre o licenciamento na sua organização.
Todos os preços sem IVA.
-
Por posto
79 PLN por posto por mês com faturação anual
99 PLN por posto por mês com faturação mensal
-
Equipa
4.800 PLN por ano
-
Piloto gratuito
30–45 dias para equipas jurídicas
Contacto
anonimize.it é um spin-off da AdActa. Fale connosco sobre licenciamento, implementação ou o seu caso de uso.