anonimize.it
anonimize.it anonimizza e pseudonimizza i dati sensibili nei documenti — interamente sulla vostra macchina.
Nulla viene caricato. I documenti restano dove sono: sul dispositivo che controllate.
PC con sistema operativo Microsoft Windows 11
Locale per progettazione
anonimize.it è pensato per le situazioni in cui i dati personali non devono lasciare il vostro ambiente. Anonimizzazione e pseudonimizzazione vengono eseguite sulla postazione di fronte a voi.
- L’elaborazione avviene sul vostro computer.
- Il contenuto dei documenti non viene inviato a un servizio remoto.
- Un adattamento pratico a flussi di lavoro orientati al GDPR che mantengono i dati personali sotto controllo locale.
Desktop, CLI e OCR
La stessa idea su più piattaforme: lavorare con i documenti senza inviarli altrove.
- Desktop per Windows e macOS Un’applicazione grafica per l’anonimizzazione quotidiana.
- CLI per Linux Uno strumento a riga di comando per script, server e ambienti senza interfaccia grafica.
- OCR per le scansioni Supporto per documenti scansionati quando il testo è disponibile solo come immagine.
Formati supportati
L’output mantiene lo stesso formato dell’input.
Documenti
- .DOCX
- .RTF
- .TXT
Scansioni e immagini (OCR locale)
- PDF da scanner
- .JPG
- .PNG
- .TIFF
- .BMP
- .GIF
Nella prossima versione
- .DOC
- .ODT
- .XLSX
- .ODS
- .PPTX
- .WEBP
Novità
-
- Nuovo tipo di maschera «Rimuovere»: il frammento selezionato scompare dal risultato senza token sostitutivo. Nella vista a due riquadri su macOS e Windows — barratura nell’origine, anteprima del risultato vuota e annullamento. Il contenuto rimosso non finisce in TXT, nell’esportazione DOCX/PDF, nella mappa né nella cache (incluse le scansioni OCR). Disponibile nella GUI (macOS/Windows) e nella CLI (detect / process --annotations).
- Elenco prodotto incorporato di circa 12.000 banche di UE/SEE/UK/CH/Balcani (sigillo aitm/eu-banks, attribuzione ECB/GLEIF). I nomi delle banche di questo elenco vengono rilevati automaticamente in tutte le versioni — senza dover mantenere un elenco proprio.
-
- Per impostazione predefinita, il testo di intestazioni e piè di pagina ripetuti non è più incluso nell’output di testo (esportazione TXT, copia per l’AI, anteprima testo). Il rilevamento e il mascheramento continuano a operare sull’intero testo, e l’esportazione PDF/DOCX conserva il layout e maschera ogni occorrenza. Un’impostazione nelle app macOS e Windows (e l’opzione CLI --include-header-footer-text) ripristina il comportamento precedente con sezioni di intestazione/piè di pagina etichettate alla fine.
- Riconoscimento di numeri di telefono internazionali oltre Polonia e Croazia: numeri +CC / 00CC con separatori comuni, convalidati rispetto alle lunghezze dei piani di numerazione per i paesi UE/SEE, Regno Unito, Svizzera, Balcani e Nord America (NANP); numeri nazionali che iniziano con 0 solo dopo un’etichetta di telefono (phone, Telefon, tél., telefono, Handy, mobile, fax…).
-
- Mascheramento degli importi monetari: nuovo tipo di dato «Importo» (etichetta [KWOTA_n]) per numeri con un marcatore di valuta prima o dopo le cifre (ad es. 500 zł, 100 €, $500), comprese le forme espresse a parole associate a una valuta. Numeri, percentuali e quote senza valuta non vengono mascherati. Disponibile negli elenchi di regole delle app macOS e Windows; codici reversibili supportati.
- I nomi di aziende noti di un elenco incorporato (banche che operano in Polonia, società WIG20/mWIG40, grandi aziende IT e assicurative), comprese varianti dei nomi, flessione polacca e ticker brevi in maiuscolo, vengono rilevati automaticamente in tutte le build — senza dover mantenere un elenco proprio.
-
- L’OCR ora gestisce le pagine PDF composte da molte tessere di immagine (scansioni a “mosaico”): l’intera pagina viene renderizzata prima dell’OCR. Su macOS l’app avvisa chiaramente quando l’OCR non ha riconosciuto testo su una pagina.
- L’output di testo (TXT, copia per AI, anteprima) per PDF di testo e DOCX termina ora con sezioni separate “Contenuto dell’intestazione” / “Contenuto del piè di pagina” invece di ripetere intestazioni e piè di pagina su ogni pagina nel corpo. L’esportazione nel formato originale conserva l’impaginazione e maschera ogni occorrenza su ogni pagina. Non vale per le scansioni OCR.
- OIB croato (11 cifre con checksum, anche con prefisso IVA HR) come tipo di dato dedicato su macOS e Windows con codici reversibili, e numeri di telefono croati (+385/00385 sempre; numeri nazionali 0xx quando etichettati come telefono). Il rilevamento funziona indipendentemente dalla lingua del documento.
- Windows: nella scheda “Decodifica” i due riquadri scorrono in sync paragrafo per paragrafo, e un connettore di paragrafi (nastri che collegano ogni paragrafo con i codici allo stesso paragrafo con i dati ripristinati) si può attivare in Impostazioni. Contrassegnare o togliere il contrassegno a una frase ora si applica a tutte le sue occorrenze con un clic.
-
- Windows: un solo modello semplice di anonimizzazione senza modalità da scegliere — tutto ciò che è testo (vista Testo, .anon.txt, Copia, anche il testo OCR da scansioni e immagini) riceve sempre codici reversibili; tutto ciò che è documento (anteprima del risultato, salvataggio DOCX / PDF / scansione / immagine) viene sempre oscurato (campi neri, irreversibile). I PDF scansionati e le immagini possono ora essere salvati come documento oscurato. La scheda “Decodifica” è uno strumento separato: incolla o trascina testo con codici da molti documenti, sulla pagina di riepilogo della deanonimizzazione vedi da quali documenti provengono i codici e quali sono rimasti sconosciuti, e da lì puoi caricare il documento di origine.
-
- Windows e CLI (Linux): il testo anonimizzato usa ora codici reversibili al posto di semplici etichette; il risultato di ogni documento va in una cronologia documenti locale crittografata (chiave nel credential store di sistema), così riaprire un file riporta il risultato precedente. Pagina Cronologia (Ctrl+H) con cartelle, ricerca (anche per codice), ordinamento, eliminazione e impostazioni di conservazione. Decodifica di una risposta AI: incolla il testo, oppure apri/trascina un file .txt, .md, .docx o .rtf — i codici provenienti da molti documenti diversi vengono ripristinati ai dati originali in un solo passaggio. La CLI ha guadagnato i comandi `registry` e `restore`.
- Riconoscimento dei nomi di località polacchi basato sui registri ufficiali dei nomi (TERYT, PRNG) e sul dizionario flessivo SGJP, comprese le forme flesse; mascherati come indirizzo.
-
- macOS: un nuovo pannello utility mobile Finestra → “Informazioni sul file” mostra il nome del file, lo stato del motore e lo stato della sessione; resta in primo piano e si aggiorna in tempo reale con la finestra attiva. Queste informazioni sono state spostate dalla finestra principale così la vista del documento è più ordinata. Chiudere il pannello non interrompe l’elaborazione. Il pulsante Salva e File → Salva… / Cmd+S sono disattivati quando non è stato rilevato né mascherato nulla (nessuna entità), così non si può esportare per sbaglio un documento invariato; si attivano appena compare una maschera.
- Una singola parola con iniziale maiuscola tra due parti dello stesso nome di persona sulla stessa riga (ad es. un secondo nome tra nome e cognome) viene ora mascherata come parte di quella persona, anche se non è stata trovata separatamente.
-
- Windows: l’originale del documento e la sua anteprima (DOCX, PDF, scansione, immagine) compaiono subito dopo il caricamento, mentre il rilevamento dei dati è ancora in corso; la ricerca (Ctrl+F) funziona già sull’originale. La scheda di avanzamento mostra la fase corrente (lettura del testo o del documento, OCR della scansione, rilevamento) con il numero di caratteri o pagine, con possibilità di annullare.
-
- Windows: nuova scheda “Risposta AI” accanto a Testo/Originale (Ctrl+R). A sinistra incolli testo con etichette (in genere la risposta di un assistente AI) e a destra vedi subito lo stesso testo con i dati originali ripristinati dalla mappa della sessione corrente, evidenziati per tipo. Il ripristino avviene in tempo reale in memoria — senza scrivere su disco file con dati personali. Riconosce le varianti di etichette che l’AI tende a produrre (es. [Osoba 1], [osoba_1], OSOBA_1) e avvisa per le etichette assenti dalla mappa. Copia e Salva (.odtworzony.txt). Si può anche caricare una mappa JSON salvata in precedenza senza un documento aperto.
- Windows: zoom del testo — Ctrl+rotella del mouse cambia la dimensione nella vista Testo e nei riquadri “Risposta AI” (75–225%); anche Impostazioni → Generali → “Dimensione testo” con ripristino al 100%. Il livello viene ricordato.
-
- Windows: anteprima del risultato anonimizzato per PDF scansionati e immagini direttamente nella vista documento (PDF raster o immagine); in precedenza disponibile solo nella vista Testo.
- Il rilevamento su grandi file .txt ora avviene in tempo lineare — in precedenza file di ~1 MB potevano richiedere oltre 10 minuti.
- L’esportazione PDF con molte entità diverse è circa 5× più veloce (es. PDF di prova da 19 pagine: da circa 30 s a circa 6 s).
-
- La regola URL maschera anche i domini nudi (es. example.pl senza http/www), gli indirizzi IPv4 nudi e host:port, oltre ai cognomi attaccati a un dominio o a un’e-mail. Usa un elenco conservativo di TLD ammessi per evitare falsi positivi sulle abbreviazioni.
- Mappature permanenti definite dall’utente nei file .aitm: elenchi di frasi (priorità: nomi di aziende) sempre mascherate. La corrispondenza tollera maiuscole/minuscole, forme giuridiche (S.A./SA/sp. z o.o.), spazi e ampersand e una lieve flessione polacca. Disponibile nella CLI (--aitm, --aitm-dir, --no-aitm) e nell’app Windows (scelta della cartella .aitm, contatore voci). Non ancora nell’interfaccia macOS.
- Scheda di audit dell’anonimizzazione (per IT/archivio, accountability GDPR art. 5(2)) senza originali e senza valori sostituiti: solo conteggi per tipo di dato, estensione del file e SHA-256; JSON + HTML. Flag CLI --audit PERCORSO e `anonimize audit --map …`; nel menu Windows “Salva scheda di audit…”. Non ancora nell’interfaccia macOS. La scheda viene prodotta anche quando l’elaborazione è bloccata (fail-closed).
- PDF: gli allegati incorporati nel file (EmbeddedFiles, annotazioni FileAttachment) vengono rimossi completamente dall’output, con un avviso.
- OCR migliore sulle scansioni a bassa risoluzione: le piccole immagini incorporate vengono ingrandite prima dell’OCR, così i nomi su tali scansioni si leggono in modo più affidabile; senza rallentamenti sulle scansioni A4 normali.
-
- PDF: le pagine di una scansione vengono riconosciute con OCR in parallelo su più core (fino a 8 pagine alla volta). Le pagine vuote nella scansione non interrompono più l’elaborazione: vengono saltate e l’app avvisa quali pagine erano vuote.
- PDF: testo corretto da file con codifiche di caratteri non standard (ad es. MacRoman, tabelle /Differences, campi modulo) e da stream di oggetti compressi, così le lettere polacche (ą, ł, ś…) vengono lette e anonimizzate correttamente. Suddivisione delle pagine ed esportazione più affidabili anche per PDF con sintassi insolita.
- Rilevamento migliore di nomi e cognomi nascosti negli indirizzi e-mail e nei nomi di dominio, anche con rumore da OCR, e di nomi scritti in minuscolo.
-
- Nuovo tipo di dati: indirizzi URL. Rilevamento e mascheramento di indirizzi interi (http/https/ftp/sftp/ssh/file/git/ws/mailto, www. senza schema, IP con porta) come [URL_n], con possibilità di disattivare questo tipo. Si puliscono anche le destinazioni nascoste dei collegamenti ipertestuali in DOCX (campi HYPERLINK, suggerimenti, link sulle immagini) e in PDF (azioni URI, collegamenti a file esterni).
- macOS: navigatore dei dati rilevati nel riquadro sinistro — albero per pagine (PDF, DOCX) o per tipo; un clic scorre fino al punto nel documento. Se il PDF ha moduli bloccati, l’app non interrompe il lavoro: salva il testo anonimizzato (TXT) con la mappa e mostra un avviso.
- Windows: «Non anonimizzare» include tutte le occorrenze dello stesso valore nel documento, dopo conferma.
- Windows: «Apri con → Anonimize.it» in Esplora file per i formati supportati (TXT, DOCX, PDF, RTF, immagini), senza sostituire il programma predefinito.
- Windows: conferma prima di sostituire il documento aperto con un file rilasciato sulla finestra.
- Le stringhe a forma di PESEL, NIP, REGON, KRS, VIN, IBAN/NRB, numero di carta d’identità, passaporto o data vengono mascherate anche quando la somma di controllo è errata o la data non esiste nel calendario (ad es. un refuso nel PESEL). Se il contesto non risolve il tipo, il frammento riceve l’etichetta «ambiguo» invece di essere saltato.
-
- Salvataggio del risultato DOCX circa 10× più veloce — su un lungo documento di test (~97 mila caratteri, ~1 600 rilevamenti) da circa 26 s a circa 2,8 s; nell’app accelera anche l’aggiornamento dell’anteprima del risultato dopo ogni modifica.
- Windows: modifica dell’occorrenza specifica selezionata nell’anteprima DOCX/PDF (non la prima nel documento); una selezione con il mouse nell’anteprima apre subito la modifica, e un clic destro su un rilevamento evidenziato consente di cambiare tipo, saltarlo o rimuoverlo.
- Windows: è possibile caricare un documento attualmente aperto in Word (l’app legge l’ultima versione salvata).
- PDF: il testo memorizzato nei moduli e nei campi PDF (incluso l’aspetto di annotazioni e campi, ad es. le caselle di spunta) viene ora rilevato e anonimizzato insieme al contenuto della pagina.
- Windows: i messaggi di salvataggio, copia, errore e avviso compaiono nel piè di pagina della finestra, con colore in base al tipo, e non coprono più il risultato.
-
- Windows: anteprima dell’originale DOCX e PDF con evidenziazione dei dati rilevati, anteprima delle immagini e scorrimento sincronizzato di entrambi i riquadri (inclusa la barra di scorrimento).
- Windows: selezionate un frammento nell’anteprima del documento e contrassegnatelo per l’anonimizzazione dal menu «Contrassegna».
- Windows: il programma di installazione installa automaticamente il runtime WebView2 se manca.
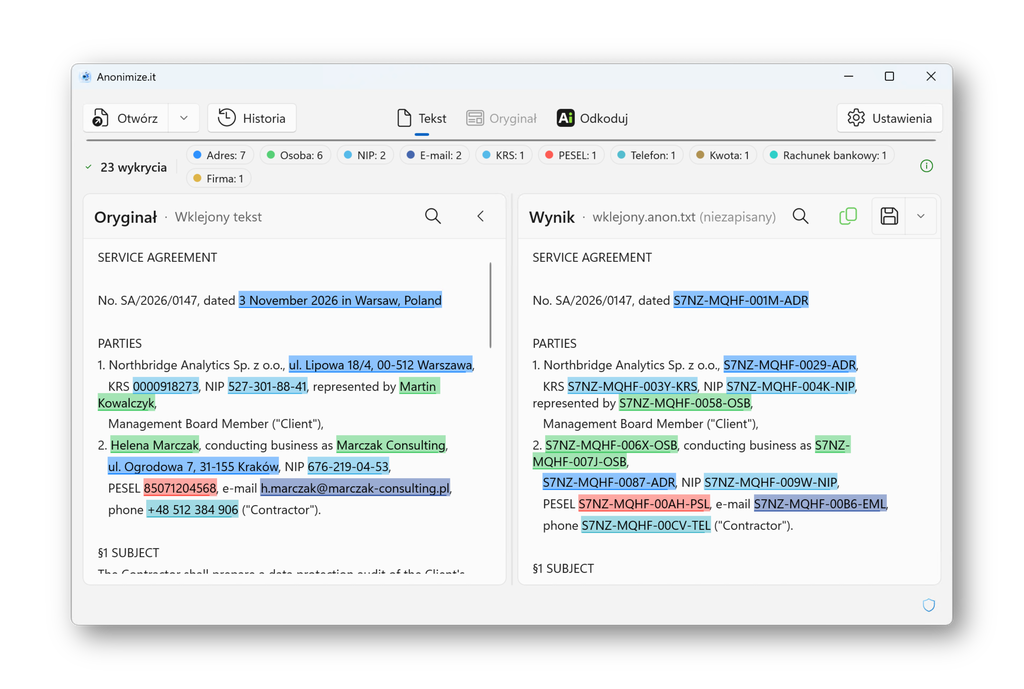
- Windows: nuova disposizione della finestra — barra con conteggio dei rilevamenti e legenda dei tipi, ricerca nei riquadri e salvataggio/copia del risultato dalla barra del riquadro risultato.
- macOS: avviso quando il modello di riconoscimento dei nomi non è stato caricato; salvataggio, copia e trascinamento del risultato richiedono allora una conferma consapevole.
- PDF: un’immagine che non può essere elaborata in sicurezza non viene inclusa nel documento di output.
-
- Windows: l’app apre DOCX, PDF (incluse le scansioni), RTF e immagini; l’OCR (Tesseract) viene installato insieme all’applicazione.
- Windows: legenda dei tipi di dati, sottolineature colorate e passaggio tra i rilevamenti con F3.
-
- Windows: nuova app Windows con programma di installazione — rilevamento dei dati nel testo, modifica manuale dei rilevamenti, salvataggio del risultato, pagina delle impostazioni e pannello degli avvisi.
- Windows: una mappa di pseudonimizzazione (JSON) consente di ripristinare i valori originali in un testo etichettato, ad esempio in una risposta di un assistente IA.
- Riconoscimento dei nomi propri polacchi flessi (ad es. «Annie», «Pawła») grazie al dizionario flessivo SGJP.
- Il mascheramento con caratteri # non rivela più la lunghezza della parola originale.
-
- DOCX: vengono anonimizzati anche intestazioni, piè di pagina, note a piè di pagina e metadati del documento.
- macOS: anteprima rapida dell’originale con contrassegni colorati in DOCX e doppio clic per passare a un rilevamento.
- PDF: sostituzione del testo più affidabile nei file con font incorporati (ToUnicode) e nei PDF giudiziari.
A chi è rivolto
Avvocati, studi legali, tribunali, pubblica amministrazione e aziende che trattano dati personali e necessitano di anonimizzazione vicino alla fonte.
Perché anonimize.it
- Lavorare in sicurezza con l’AI Maschera → lavora in AI (ad es. Claude Code, ChatGPT) → ripristina i dati. I valori sensibili nel testo diventano codici reversibili; la cronologia documenti locale consente poi di ripristinare gli originali.
- CLI per Linux Maschera e ripristina dal terminale, da usare nei propri script.
- Completamente offline I dati non lasciano il vostro computer; l’app funziona senza internet. Nessuna telemetria e nessuna attivazione online.
Prezzi
Piani per team legali. Parlateci della licenza per la vostra organizzazione.
Tutti i prezzi IVA esclusa.
-
Per postazione
79 PLN per postazione al mese con fatturazione annuale
99 PLN per postazione al mese con fatturazione mensile
-
Team
4.800 PLN all’anno
-
Pilota gratuito
30–45 giorni per team legali
Contatti
anonimize.it è uno spin-off di AdActa. Parlateci di licenze, distribuzione o del vostro caso d’uso.