anonimize.it
anonimize.it anonimizuje i pseudonimizuje dane wrażliwe w dokumentach — wyłącznie na Twoim komputerze.
Nic nie jest wysyłane. Dokumenty zostają tam, gdzie są: na urządzeniu, które kontrolujesz.
Komputer PC z systemem operacyjnym Microsoft Windows 11
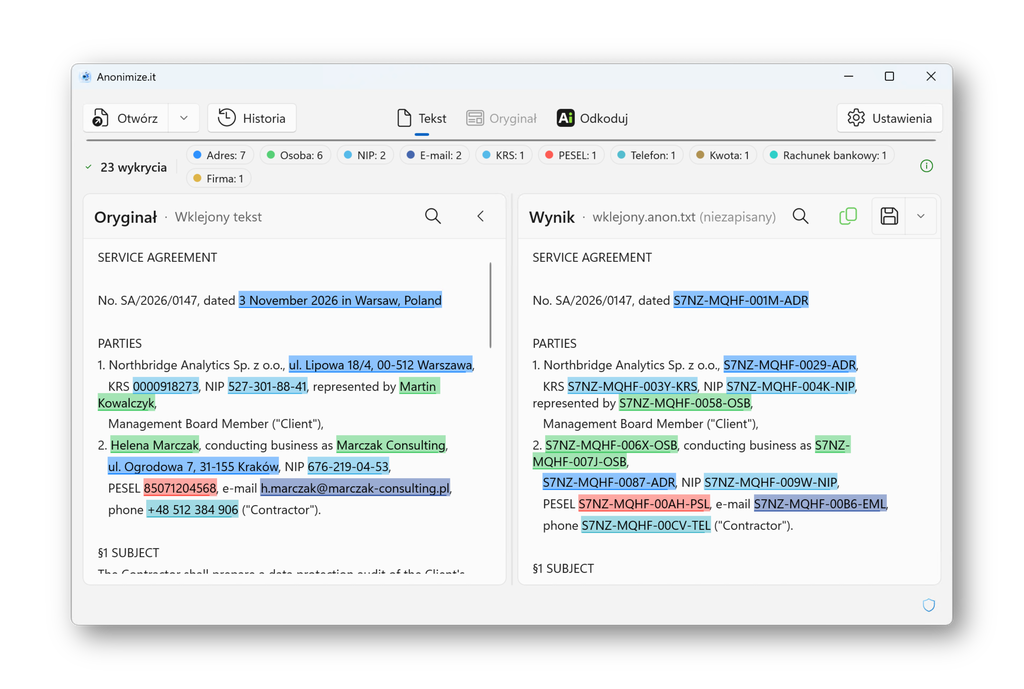
Lokalnie z założenia
anonimize.it powstało z myślą o sytuacjach, w których dane osobowe nie mogą opuścić Twojego środowiska. Anonimizacja i pseudonimizacja działają na stacji roboczej przed Tobą.
- Przetwarzanie odbywa się na Twoim komputerze.
- Treść dokumentów nie jest wysyłana do zdalnej usługi.
- Praktyczne dopasowanie do procesów zgodnych z RODO, które utrzymują dane osobowe pod lokalną kontrolą.
Desktop, CLI i OCR
Ta sama idea na różnych platformach: praca z dokumentami bez wysyłania ich gdzie indziej.
- Desktop na Windows i macOS Aplikacja graficzna do codziennej anonimizacji.
- CLI dla Linuksa Narzędzie wiersza poleceń do skryptów, serwerów i środowisk bez GUI.
- OCR dla skanów Wsparcie dla dokumentów skanowanych, gdy tekst jest dostępny tylko jako obraz.
Obsługiwane formaty
Wyjście zachowuje ten sam format co wejście.
Dokumenty
- .DOCX
- .RTF
- .TXT
Skany i obrazy (lokalne OCR)
- PDF ze skanera
- .JPG
- .PNG
- .TIFF
- .BMP
- .GIF
W najbliższej wersji
- .DOC
- .ODT
- .XLSX
- .ODS
- .PPTX
- .WEBP
Nowe funkcje
-
- Nowy typ maski „Usunąć”: zaznaczony fragment znika z wyniku bez tokenu zastępczego. W widoku dwóch paneli na macOS i Windows — przekreślenie w źródle, pusty podgląd wyniku i możliwość cofnięcia. Usunięta treść nie trafia do TXT, eksportu DOCX/PDF, mapy ani cache (w tym skany OCR). Dostępne w GUI (macOS/Windows) oraz w CLI (detect / process --annotations).
- Wbudowana produktowa lista ok. 12 000 banków UE/EOG/UK/CH/Bałkanów (pieczęć aitm/eu-banks, atrybucja ECB/GLEIF). Nazwy banków z tej listy są wykrywane automatycznie we wszystkich wersjach — bez utrzymywania własnej listy.
-
- Domyślnie tekst powtarzających się nagłówków i stopek nie jest już dołączany do wyjścia tekstowego (eksport TXT, kopiowanie do AI, podgląd tekstu). Wykrywanie i maskowanie nadal obejmują pełny tekst, a eksport PDF/DOCX zachowuje układ i maskuje każde wystąpienie. Ustawienie w aplikacjach macOS i Windows (oraz opcja CLI --include-header-footer-text) przywraca poprzednie zachowanie z oznaczonymi sekcjami nagłówka/stopki na końcu.
- Rozpoznawanie międzynarodowych numerów telefonów poza Polską i Chorwacją: numery +CC / 00CC z typowymi separatorami, weryfikowane względem długości planu numeracyjnego dla krajów UE/EOG, UK, Szwajcarii, Bałkanów i Ameryki Północnej (NANP); numery krajowe zaczynające się od 0 tylko po etykiecie telefonu (phone, Telefon, tél., telefono, Handy, mobile, fax…).
-
- Maskowanie kwot pieniężnych: nowy typ danych „Kwota” (etykieta [KWOTA_n]) dla liczb ze znacznikiem waluty przed lub po cyfrach (np. 500 zł, 100 €, $500), także formy słowne przy walucie. Liczby, procenty i udziały bez waluty nie są maskowane. Dostępne na listach reguł w aplikacjach macOS i Windows; obsługiwane odwracalne kody.
- Znane nazwy firm z wbudowanej listy (banki działające w Polsce, spółki WIG20/mWIG40, duże firmy IT i ubezpieczeniowe), z wariantami nazw, polską odmianą i krótkimi tickerami wielkimi literami, są wykrywane automatycznie we wszystkich wersjach — bez utrzymywania własnej listy.
-
- OCR obsługuje teraz strony PDF złożone z wielu kafelków obrazu („mozaikowe” skany): cała strona jest renderowana przed OCR. Na macOS aplikacja wyraźnie ostrzega, gdy OCR nie rozpoznał tekstu na stronie.
- Wyjście tekstowe (TXT, kopiowanie do AI, podgląd) dla tekstowych PDF i DOCX kończy się teraz osobnymi sekcjami „Treść nagłówka” / „Treść stopki” zamiast powtarzać nagłówki i stopki na każdej stronie w treści. Eksport w oryginalnym formacie zachowuje układ i maskuje każde wystąpienie na każdej stronie. Nie dotyczy skanów OCR.
- Chorwacki OIB (11 cyfr z sumą kontrolną, także z prefiksem VAT HR) jako osobny typ danych na macOS i Windows z odwracalnymi kodami oraz chorwackie numery telefonów (+385/00385 zawsze; krajowe numery 0xx, gdy oznaczone jako telefon). Wykrywanie działa niezależnie od języka dokumentu.
- Windows: na zakładce „Odkoduj” oba panele przewijają się synchronicznie akapit po akapicie, a łącznik akapitów (wstążki łączące każdy akapit z kodami z tym samym akapitem z przywróconymi danymi) można włączyć w Ustawieniach. Oznaczenie lub odznaczenie frazy obejmuje teraz wszystkie jej wystąpienia jednym kliknięciem.
-
- Windows: jeden prosty model anonimizacji bez wyboru trybu — wszystko, co jest tekstem (widok Tekst, .anon.txt, Kopiuj, także tekst OCR ze skanów i obrazów), zawsze dostaje odwracalne kody; wszystko, co jest dokumentem (podgląd wyniku, zapis DOCX / PDF / skanu / obrazu), zawsze jest zamazywane (czarne pola, nieodwracalnie). Zeskanowane PDF-y i obrazy można teraz zapisać jako zamazany dokument. Zakładka „Odkoduj” to osobne narzędzie: wklejasz lub upuszczasz tekst z kodami z wielu dokumentów, na stronie podsumowania deanonimizacji widać, z których dokumentów pochodzą kody i które pozostały nieznane, a stamtąd można wczytać dokument źródłowy.
-
- Windows i CLI (Linux): zanonimizowany tekst używa odwracalnych kodów zamiast zwykłych etykiet; wynik każdego dokumentu trafia do zaszyfrowanej lokalnej historii dokumentów (klucz w systemowym magazynie poświadczeń), więc ponowne otwarcie pliku przywraca poprzedni wynik. Strona Historii (Ctrl+H) z folderami, wyszukiwaniem (także po kodzie), sortowaniem, usuwaniem i ustawieniami retencji. Odkodowanie odpowiedzi AI: wklejenie tekstu albo otwarcie/przeciągnięcie pliku .txt, .md, .docx lub .rtf — kody z wielu różnych dokumentów są przywracane do oryginalnych danych w jednym kroku. CLI zyskało polecenia `registry` i `restore`.
- Rozpoznawanie polskich nazw miejscowości na podstawie oficjalnych rejestrów nazw (TERYT, PRNG) oraz słownika fleksyjnego SGJP, także w formach odmienionych; maskowane jako adres.
-
- macOS: nowe pływające okno narzędziowe Okno → „Informacje o pliku” pokazuje nazwę pliku, status silnika i status sesji; pozostaje na wierzchu i aktualizuje się na żywo wraz z aktywnym oknem. Te informacje przeniesiono z głównego okna, żeby widok dokumentu był czytelniejszy. Zamknięcie panelu nie przerywa przetwarzania. Przycisk Zapisz oraz Plik → Zapisz… / Cmd+S są nieaktywne, gdy nic nie wykryto ani nie zamaskowano (brak jednostek) — nie da się przypadkiem wyeksportować niezmienionego dokumentu; aktywują się, gdy pojawi się pierwsza maska.
- Pojedyncze słowo z wielką literą między dwoma częściami tego samego imienia i nazwiska w tej samej linii (np. drugie imię między imieniem a nazwiskiem) jest teraz maskowane jako część tej osoby, nawet jeśli nie zostało wykryte osobno.
-
- Windows: oryginał dokumentu i jego podgląd (DOCX, PDF, skan, obraz) widać od razu po wczytaniu, jeszcze w trakcie wykrywania danych; wyszukiwanie (Ctrl+F) działa już na oryginale. Karta postępu pokazuje bieżący etap (odczyt tekstu lub dokumentu, OCR skanu, wykrywanie) z liczbą znaków lub stron, z możliwością anulowania.
-
- Windows: nowa zakładka „Odpowiedź AI” obok Tekst/Oryginał (Ctrl+R). Wklejasz po lewej tekst z etykietami (typowo odpowiedź asystenta AI), a po prawej od razu widać ten sam tekst z przywróconymi oryginalnymi danymi z mapy bieżącej sesji, podświetlonymi według typu. Przywracanie działa na żywo w pamięci — bez zapisu plików z danymi osobowymi na dysk. Rozpoznaje warianty etykiet, które bywa, że generuje AI (np. [Osoba 1], [osoba_1], OSOBA_1), i ostrzega o etykietach spoza mapy. Kopiuj oraz Zapisz (.odtworzony.txt). Można też wczytać wcześniej zapisaną mapę JSON bez otwartego dokumentu.
- Windows: powiększanie tekstu — Ctrl+kółko myszy zmienia rozmiar w widoku Tekst i w panelach „Odpowiedź AI” (75–225%); także Ustawienia → Ogólne → „Rozmiar tekstu” z przywróceniem do 100%. Poziom jest zapamiętywany.
-
- Windows: podgląd zanonimizowanego wyniku dla skanów PDF i obrazów bezpośrednio w widoku dokumentu (raster PDF lub obraz); wcześniej był dostępny tylko w widoku Tekst.
- Wykrywanie w dużych plikach .txt działa w czasie liniowym — wcześniej pliki ~1 MB mogły zajmować ponad 10 minut.
- Eksport PDF z wieloma różnymi jednostkami jest ok. 5× szybszy (np. testowy PDF 19 stron: z ok. 30 s do ok. 6 s).
-
- Reguła URL maskuje też gołe domeny (np. example.pl bez http/www), gołe adresy IPv4 oraz host:port, a także nazwiska sklejone z domeną lub adresem e-mail. Używa konserwatywnej listy dozwolonych TLD, żeby unikać fałszywych trafień na skrótach.
- Stałe mapowania użytkownika w plikach .aitm: listy fraz (priorytet: nazwy firm), które są zawsze maskowane. Dopasowanie toleruje wielkość liter, formy prawne (S.A./SA/sp. z o.o.), spacje i ampersand oraz lekką odmianę polską. Dostępne w CLI (--aitm, --aitm-dir, --no-aitm) oraz w aplikacji Windows (wybór folderu .aitm, licznik wpisów). Jeszcze nie w interfejsie macOS.
- Karta audytu anonimizacji (dla IT/archiwum, rozliczalność RODO art. 5 ust. 2) bez oryginałów i bez wartości zastąpionych: tylko liczby według typu danych, rozszerzenie pliku i SHA-256; JSON + HTML. Flaga CLI --audit ŚCIEŻKA oraz `anonimize audit --map …`; w Windows menu „Zapisz kartę audytu…”. Jeszcze nie w interfejsie macOS. Karta powstaje także gdy przetwarzanie jest zablokowane (fail-closed).
- PDF: załączniki osadzone w pliku (EmbeddedFiles, adnotacje FileAttachment) są w pełni usuwane z wyniku, z ostrzeżeniem.
- Lepsze OCR na skanach niskiej rozdzielczości: małe osadzone obrazy są powiększane przed OCR, więc imiona i nazwiska na takich skanach są odczytywane pewniej; bez spowolnienia typowych skanów A4.
-
- PDF: strony skanu są rozpoznawane OCR równolegle na kilku rdzeniach (do 8 stron naraz). Puste kartki w skanie nie przerywają już przetwarzania — są pomijane, a program ostrzega, które strony były puste.
- PDF: poprawny tekst z plików z niestandardowym kodowaniem znaków (np. MacRoman, tablice /Differences, pola formularzy) i ze skompresowanymi strumieniami obiektów, więc polskie litery (ą, ł, ś…) są odczytywane i anonimizowane poprawnie. Poprawne rozdzielanie stron i eksport PDF-ów o nietypowej składni.
- Lepsze wykrywanie imion i nazwisk ukrytych w adresach e-mail i nazwach domen, także przy zakłóceniach z OCR, oraz imion zapisanych małą literą.
-
- Nowy typ danych: adresy URL. Wykrywanie i maskowanie całych adresów (http/https/ftp/sftp/ssh/file/git/ws/mailto, www. bez schematu, IP z portem) jako [URL_n], z możliwością wyłączenia tego typu. Czyszczone są też ukryte cele hiperłączy w DOCX (pola HYPERLINK, podpowiedzi, linki na obrazkach) i w PDF (akcje URI, odnośniki do plików zewnętrznych).
- macOS: nawigator wykrytych danych w lewym panelu — drzewo według stron (PDF, DOCX) lub typów; kliknięcie przewija do miejsca w dokumencie. Gdy PDF ma zablokowane formularze, aplikacja nie przerywa pracy: zapisuje zanonimizowany tekst (TXT) z mapą i pokazuje ostrzeżenie.
- Windows: „Nie anonimizuj” obejmuje wszystkie wystąpienia tej samej wartości w dokumencie, po potwierdzeniu.
- Windows: „Otwórz za pomocą → Anonimize.it” w Eksploratorze plików dla obsługiwanych formatów (TXT, DOCX, PDF, RTF, obrazy), bez przejmowania domyślnego programu.
- Windows: potwierdzenie przed zastąpieniem otwartego dokumentu plikiem upuszczonym na okno.
- Ciągi w kształcie PESEL, NIP, REGON, KRS, VIN, IBAN/NRB, numeru dowodu, paszportu lub daty są maskowane także wtedy, gdy suma kontrolna jest błędna albo data nie istnieje w kalendarzu (np. literówka w PESEL). Gdy kontekst nie rozstrzyga typu, fragment dostaje etykietę „niejednoznaczny” zamiast zostać pominięty.
-
- Zapis wyniku DOCX ok. 10× szybszy — w długim dokumencie testowym (~97 tys. znaków, ~1 600 wykryć) z ok. 26 s do ok. 2,8 s; w aplikacji przyspiesza to też odświeżanie podglądu wyniku po każdej edycji.
- Windows: edycja konkretnego zaznaczonego wystąpienia w podglądzie DOCX/PDF (a nie pierwszego w dokumencie); zaznaczenie myszą w podglądzie od razu otwiera edycję, a prawy klik na podświetlonym wykryciu pozwala zmienić jego typ, pominąć je lub usunąć.
- Windows: można wczytać dokument, który jest akurat otwarty w Wordzie (aplikacja czyta ostatnio zapisaną wersję).
- PDF: tekst zapisany w formularzach i polach PDF (Form XObject, wygląd adnotacji i pól, np. checkboxów) jest teraz wykrywany i anonimizowany razem z treścią strony.
- Windows: komunikaty o zapisie, kopiowaniu, błędach i ostrzeżeniach pojawiają się w stopce okna, w kolorze zależnym od rodzaju, i nie zasłaniają wyniku.
-
- Windows: podgląd oryginału DOCX i PDF z podświetleniem wykrytych danych, podgląd obrazów oraz synchronizacja przewijania obu paneli (także paskiem przewijania).
- Windows: zaznacz fragment w podglądzie dokumentu i oznacz go jako dane do anonimizacji z menu „Oznacz”.
- Windows: instalator sam doinstaluje WebView2 Runtime, jeśli go brakuje.
- Windows: nowy układ okna — pasek z liczbą wykryć i legendą typów, wyszukiwanie w panelach, zapis i kopiowanie wyniku z listwy panelu wyniku.
- macOS: ostrzeżenie, gdy model rozpoznawania nazw nie został załadowany; zapis, kopiowanie i przeciąganie wyniku wymagają wtedy świadomego potwierdzenia.
- PDF: obraz, którego nie da się bezpiecznie przetworzyć, nie trafia do wynikowego dokumentu.
-
- Windows: aplikacja otwiera DOCX, PDF (również skany), RTF i obrazy; OCR (Tesseract) jest instalowany razem z aplikacją.
- Windows: legenda typów danych, kolorowe podkreślenia i przechodzenie między wykryciami klawiszem F3.
-
- Windows: nowa aplikacja na Windows z instalatorem — wykrywanie danych w tekście, ręczna edycja wykryć, zapis wyniku, strona ustawień i panel ostrzeżeń.
- Windows: mapa pseudonimizacji (JSON) pozwala odtworzyć oryginalne dane w tekście z etykietami, np. w odpowiedzi otrzymanej od asystenta AI.
- Rozpoznawanie odmienionych polskich imion (np. „Annie”, „Pawła”) dzięki słownikowi fleksyjnemu SGJP.
- Maskowanie znakami # nie zdradza już długości oryginalnego słowa.
-
- DOCX: anonimizowane są także nagłówki, stopki, przypisy i metadane dokumentu.
- macOS: szybki podgląd oryginału z kolorowymi oznaczeniami w DOCX i podwójne kliknięcie, by przejść do wykrycia.
- PDF: pewniejsza podmiana tekstu w plikach z osadzonymi czcionkami (ToUnicode) i w PDF-ach sądowych.
Dla kogo
Dla prawników, kancelarii, sądów, administracji publicznej oraz firm przetwarzających dane osobowe, które potrzebują anonimizacji blisko źródła.
Dlaczego anonimize.it
- Bezpieczna praca z AI Zamaskuj → pracuj w AI (np. Claude Code, ChatGPT) → przywróć dane. Wrażliwe wartości w tekście stają się odwracalnymi kodami; lokalna historia dokumentów pozwala potem przywrócić oryginały.
- CLI na Linuksa Maskuje i przywraca dane z terminala — do użycia we własnych skryptach.
- W pełni offline Dane nie opuszczają Twojego komputera, aplikacja działa bez internetu. Bez telemetrii i bez aktywacji online.
Cennik
Plany dla zespołów prawnych. Porozmawiaj z nami o licencjonowaniu w Twojej organizacji.
Wszystkie ceny netto.
-
Za stanowisko
79 zł za stanowisko miesięcznie przy rozliczeniu rocznym
99 zł za stanowisko miesięcznie przy rozliczeniu miesięcznym
-
Zespół
4 800 zł rocznie
-
Bezpłatny pilotaż
30–45 dni dla zespołów prawnych
Kontakt
anonimize.it to spinoff AdActa. Porozmawiaj z nami o licencjonowaniu, wdrożeniu lub swoim przypadku użycia.